当人工智能从内容生成走向更深层次的模型训练和产业应用,版权规则也被推到新的技术坐标系中:海量作品进入训练数据,是否应当逐一获得授权?“合法来源”能否等同于有权使用?用户输入提示词后生成的图片、文字、视频,是不是著作权法意义上的作品?出版机构的高质量内容,又如何从传统出版资源转化为人工智能时代可授权、可运营、可增值的版权资产?
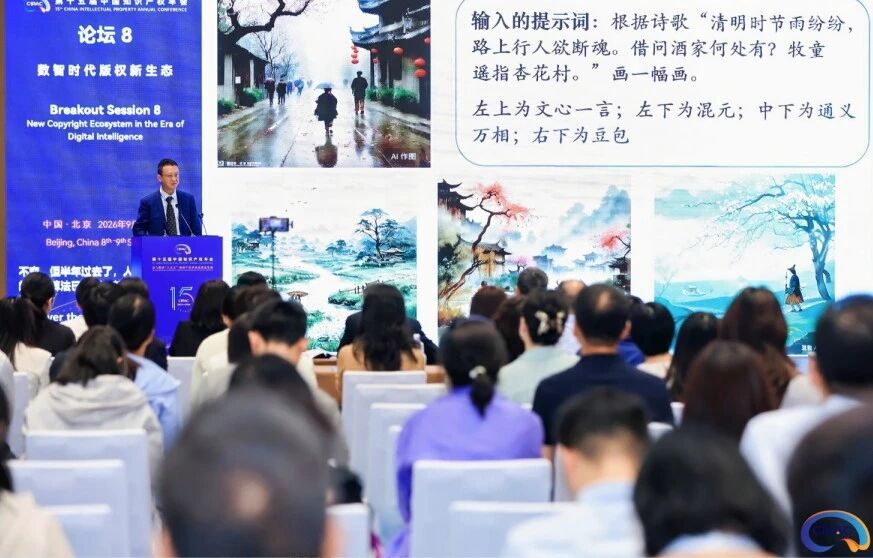
在第十五届中国知识产权年会期间,由知识产权出版社主办的“数智时代版权新生态”论坛汇聚了来自版权法治建设、出版产业、法学研究、互联网科技领域的权威专家。与会嘉宾紧扣数智时代驱动下版权生态重构的核心趋势,聚焦AI生成内容合规应用,数字内容创新创作,版权确权及跨主体授权、内容业态、模式创新、版权产业价值转化等核心议题,展开深度讨论与分享
第十五届中国知识产权年会“数智时代版权新生态”论坛现场。
主办方供图
AI 训练作品授权边界如何厘清
生成式人工智能的发展离不开海量数据。当图书、论文、图片、音乐等受著作权保护的作品进入训练数据,首先需要回答的是:这种使用在著作权法意义上如何定性?
原国务院法制办副主任、第八届中国法学会副会长甘藏春认为,数智时代给版权制度带来的挑战是系统性的,既涉及权属认定、海量数据授权、侵权责任划分,也带来版权利用形态的变化——创作走向人机协同,作品价值由内容阅读向数据训练延伸,版权资产也呈现数字化、可流转、可溯源的趋势。
面对这些变化,传统的一对一授权方式首先受到挑战。“要立足现实,积极探索加快推进训练数据使用授权机制和收费机制的建立。”甘藏春表示,面对海量数据使用,可以进一步探索出版社联合、著作权 组织集体授权和集体收费等机制。
“我们现在处在一个相持阶段, 一方面数智技术日新月异,另一方面现行法律是依照工业社会的底层逻辑设计的。”甘藏春表示,应保持战略定力,通过司法裁判、司法解释、部门规章、地方立法等多种机制“小步快跑”,在实践中积累经验、寻找平衡点。
国家版权局原副局长、中国版 权协会原理事长阎晓宏同样将“平衡”视为构建版权新生态的重要原则。“最根本的还是权利和权利使用的平衡问题。”阎晓宏表示,新的版权生态既要有利于激发创作活力,也要有利于产业发展,并最终惠及社会公众。
阎晓宏还关注到训练数据的透明问题。面对规模庞大、技术过程复杂的训练数据,权利人往往难以知晓作品是否被使用,也面临举证困难。“透明原则非常重要。”阎晓宏指出,对于作品使用后的利益安排,可探索价值贡献补偿、收益分成和利益分享等机制;在相关立法尚未完善时,也可通过权利人组织与大模型企业协商寻找解决方案。
训练数据“来源合法”是不是意味着可以直接用于模型训练?围绕这一问题,中宣部版权管理局原副局长的段玉萍作出了区分。在她看来,购买正版图书、期刊等,只能说明数据获取来源合法,并不能取得复制、信息网络传播等著作权法意义上的权利。“数据来源合法和是不是获得著作权法意义上的授权是两个概念。”段玉萍表示,AI训练首先涉及对作品的复制,而复制权 是著作权人的重要权利。在现有制度下,应当区分合法取得载体与获得版权授权两个层面。
围绕AI训练是否能够适用合理使用,段玉萍进一步从现行《著作权法》框架做了分析。她认为,人工智能训练通常包括数据抓取、存储、拆解、转换、学习和输出等多个环节,而其中复制是不可回避的基础行为。目前我国 《著作权法》 规定的合理使用情形中,并没有针对AI训练作出专门规定,因此不能简单照搬其他国家关于“转换性使用”的判断逻辑。
华东政法大学学术委员会副主任委员王迁认为,大模型训练需要建立庞大的语料库,其中包含大量作品,由此发生的复制行为不能因为后续模型生成的内容不直接复现原作,脱离复制权的规制。“要训练大模型,必须建立一个庞大的语料库,而语料库中有海量的作品,这是一个未经著作权许可进行的复制行为。”王迁表示。
中国社会科学院知识产权中心主任管育鹰将关注点更多放在不同使用场景及是否形成竞争关系上。她认为,科研、公共文化等非竞争性使用,与进入文化产业领域、可能形成市场替代的商业性使用,应当有所区分。同时,人工智能训练过程具有较强的技术复杂性,权利人往往难以掌握训练数据来源、训练过程等信息。管育鹰认为,可以通过司法个案进一步积累经验,并在举证责任安排上形成适当平衡。
腾讯研究院法律研究负责人朱开鑫从全球规则演进角度介绍,目前各国主要形成两类路径:一类通过合理使用“四要素”规则进行个案判断,另一类通过“文本与数据挖掘”等权利限制制度回应模型训练问题。在前一类路径中,需要结合内容来源合法性、使用目的、市场替代影响等因素,在具体案件中进一步判断。在后一类路径中,目前趋势是强调对既有版权例外规则的适用限制,明确“例外的例外”,实现版权行业与模型产业的利益平衡。他认为,保障版权人反对作品被用于训练的权利、坚持训练数据来源合法、规制训练后直接输出被训练作品,是当前值得关注的几个方面。
AIGC 生成创作与责任如何认定
输入一句话,一幅画可能在数秒内生成;提供一段文字,一个视频片段也能快速出现。人工智能生成内容日益丰富之后,另一个问题随之而来:这些内容是否是著作权法意义上的“作品”?
王迁认为,回答这一问题,关键仍然要回到“创作”本身。他提出,著作权法意义上的创作,需要人的自由意志对构成作品的表达性要素产生直接、具有主导性的作用,而不能仅仅对最终结果产生间接影响。
“创作是由人的自由意志直接决定构成作品的表达性要素。”王迁表示,人工智能可以成为人类创作的辅助工具,但是否形成受《著作权法》保护的作品,还应进一步考察人在最终表达形成过程中究竟作出了何种具体的创作贡献。
为说明提示词与最终生成内容之间的关系,王迁介绍了自己所做的一项实验:将相同提示词和参数输入不同生成式人工智能,甚至在不同硬件环境中运行同一人工智能并进行完全相同的输入,得到的结果仍存在明显差异,他还通过公证方式对实验过程进行了复现。王迁据此认为,提示词会影响生成结果,却并不能直接决定最终表达。“提示词相对于人工智能生成内容而言是思想。一个创作行为不可能产生许多截然不同的作品,但一个思想可以对应不同的内容。”王迁说。
然而,AI 生成内容本身能否成为作品,与人能否借助AI完成创作,是两个不同的问题。
王迁将人工智能辅助创作进一步区分为多种情形:创作者可以从AI生成内容中获得创意启发,再自行完成作品;可以对AI生成内容进行具有独创性的实质修改;也可以对大量 AI生成片段进行具有独创性的选择、剪辑和编排。只要人的后续智力活动符合《著作权法》规定的独创性要求,相应的人类创作成果仍有进入版权保护范围的可能。
“如果以人工智能生成内容为基础进行后续修改,出现了一定的差异,达到独创性要求,当然可以认定为作品。”王迁介绍,如果只是删除错字、修补瑕疵等技术性修改,并不足以形成新的独创性表达。
除了“生成物是不是作品”,人工智能服务过程中究竟在哪个环节可能发生侵权,也成为产业界关注的问题。
阿里研究院人工智能治理中心主任傅宏宇提出,应更加细致地区分“模型”与“服务”。“这就要求在进行合规分析时,要深入到技术细节里,看哪个部分真正发生内容复制。”傅宏宇表示,在实际应用中,用户最终看到的内容并不一定完全由基础模型直接生成,也可能叠加检索增强生成、插件、外部数据库等技术环节。因此,分析是否发生复制、复现以及由谁承担责任,需要深入具体技术链条,而不能把模型训练、模型能力与最终服务提供简单混为一谈。
傅宏宇认为,版权合规还需要落实到具体服务环节。例如,通过技术手段减少训练内容在输出端被直接复现,对提示词和生成结果进行必要处理;如果问题来自外部数据库、检索增强或插件,也应针对具体来源采取相应治理措施。
从权利保护走向价值共创
规则边界之外,出版业更关心一个现实问题:手中的优质内容,如何真正进入人工智能时代的价值链?
中国大百科全书出版社党委书记、社长高世屹认为,人工智能时代并不缺少信息,真正稀缺的是经过专业生产、审校和持续更新形成的高质量、可信、系统化知识。“在一切皆可生成的时代,百科的壁垒,或者说出版界优质图书的壁垒,不是独家信息,也不是编纂效率的提升,而是可信的权威知识体系和持续构建生态的能力。”高世屹表示,中国大百科全书出版社正在推动传统出版内容向人工智能应用场景延伸。他介绍,该社已牵头组建人工智能高质量语料库建设联盟,22 家单位参与其中,并与人工智能平台探索知识资源应用,目前已通过应用程序编程接口(API)调用等方式开展相关合作,同时探索授权大模型使用高质量语料进行训练以及开发专属智能体等路径,尝试让传统出版内容从“书”进一步转化为能够进入数字应用场景的知识资源。
对于与人工智能企业合作,高世屹明确提出:“授权是前提,先授权后使用,这是我们出版界的底线。”
面对人工智能企业对高质量内容资源不断增长的需求,出版机构应该如何应对?段玉萍认为要“积极发声、抱团取暖、做好自己、寻求合作”。她提到,已有出版社在图书版权页明确提出“禁止未经许可将内容用于人工智能训练”;一些媒体也通过更新版权声明,对 AI训练、机器学习、数据挖掘等使用场景作出明确限制。
段玉萍认为,出版机构既要明确表达自身对AI训练使用作品的版权诉求、加强行业协作,也要梳理自身权利基础。出版社与作者之间的合同是否覆盖人工智能训练等新的使用场景,会直接影响出版社未来有没有权利进行授权以及如何开展相关合作。对于这种合作如 何从一次授权进一步走向长期利益共享,互联网企业 也在思考新的可能性 。傅宏宇认为,单一语料对于模型能力的实际贡献很难事先判断,一次性许可使用费也未必能够解决全部问题。在他看来,除现有版权合规措施外,还可以进一步探索权利人参与人工智能发展、收入共享等合作方式。
“归根结底,要构建一种基于合作的共同利益,形成合理的利益分配机制。”傅宏宇表示,未来除了通过技术手段防止侵权内容输出,还应进一步探索内容方、平台和开发者之间的合作模式,实现各方相互成就。
论坛尾声,知识产权出版社总编辑刘洋代表主办方提出,坚持合规为先、技术向善,规范 AI 训练的数据使用、内容生成与传播运营;坚持价值为本、盘活资产,完善版权确权、授权、流转与价值转化机制;坚持开放协同、共建生态,推动内容机构、科技企业、研究机构、行业协会等多方联动,构建规范透明、互利共赢的版权合作体系。
从训练数据如何使用到生成内容如何认定,再到优质内容如何授权、价值如何分配,数智时代的版权问题仍在随着技术发展不断变化。如何在保护创作与促进技术创新之间找到更加清晰、可持续的规则路径,仍需要产业各方在实践中继续探索。

电子邮箱:nmgcbjtbgs@163.com
联系电话:(0471) 6661859
信箱地址:呼和浩特市新华大街89号出版大厦1楼大厅群众意见箱
电子邮箱:nmgcbjtdwxcb@163.com
联系电话:(0471) 6661859
信箱地址:呼和浩特市新华大街89号出版大厦1楼大厅群众意见箱


